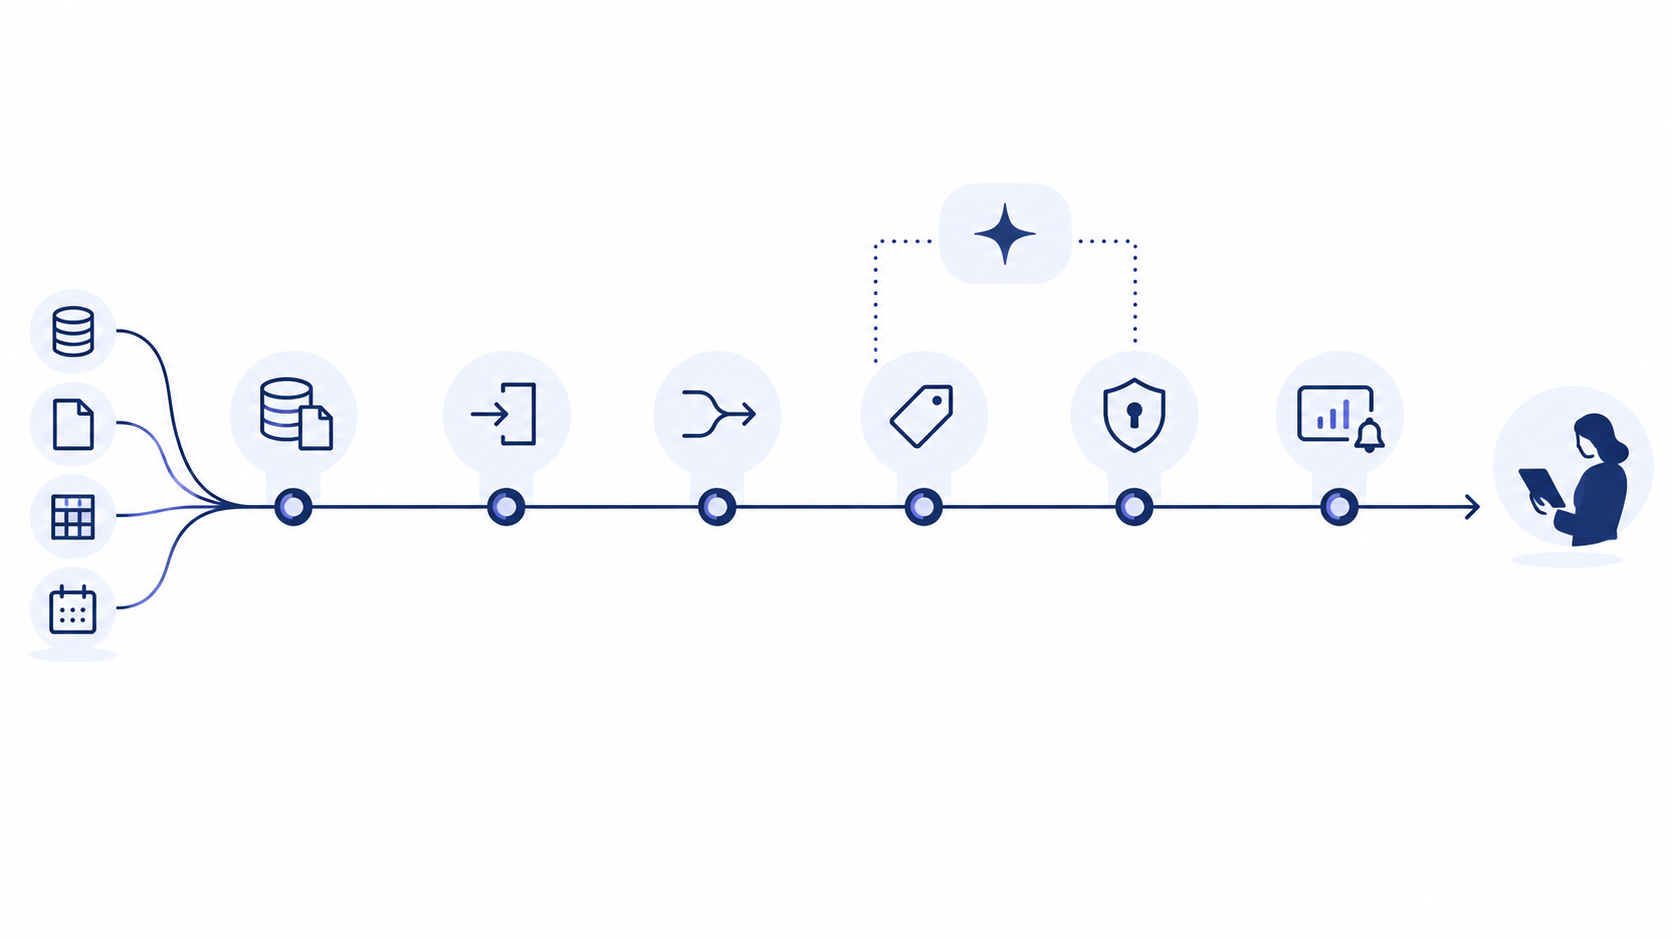
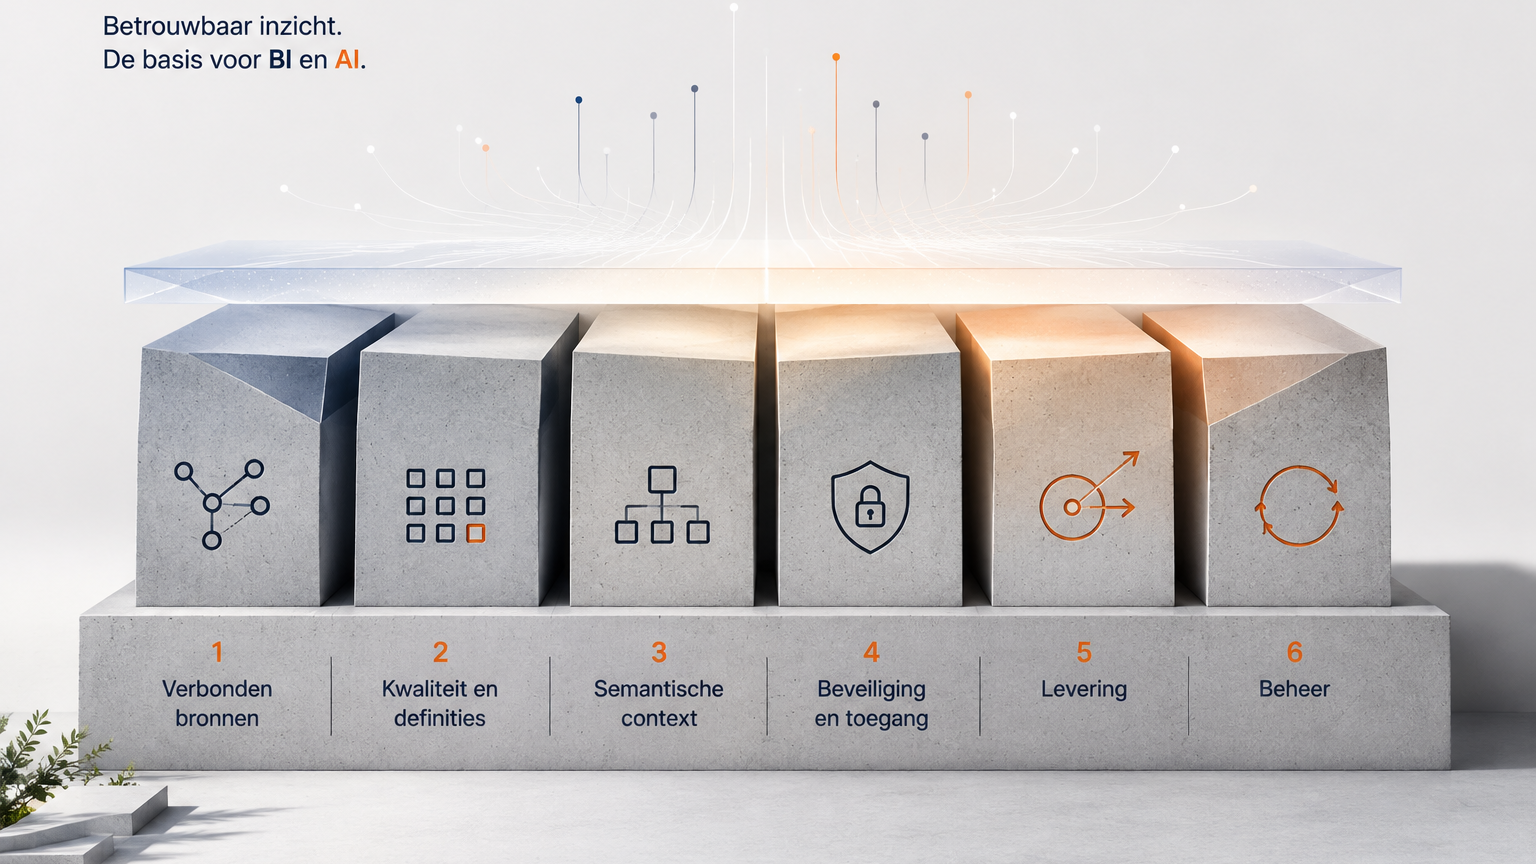
Tussen het moment dat een order in je ERP wordt vastgelegd en het moment dat iemand er in gewone taal een vraag over stelt, zitten zes stations. Dit artikel loopt ze langs, in gewone taal, met per station wat er gebeurt en wat er misgaat als je het overslaat. Bedoeld voor wie beslist over dit soort investeringen en er niet dagelijks mee werkt.
Wat dit artikel oplevert
- Je kunt de keten van bron tot antwoord in zes stappen navertellen.
- Je herkent bij welk station een probleem ontstaat als een cijfer niet klopt.
- Je begrijpt waar RAG in het geheel past en waarom dat de laatste stap is.
- Je kunt beoordelen of een aanbieding van een leverancier de hele keten dekt of één station.
Station 1. De bron
Het begint bij de systemen die er al staan. Een ERP dat klanten, orders en facturen kent. Een servicedesk met meldingen. Een planningspakket met uren. Vaak nog een branchespecifiek pakket, en daaromheen spreadsheets waarin mensen de gaten hebben gedicht.
Wat belangrijk is om te onthouden: elk van die systemen slaat gegevens op zoals het systeem ze nodig heeft, niet zoals jij ze wilt lezen. Een ERP is gebouwd om een order door een proces te duwen, niet om een vraag over marge te beantwoorden. Dat is geen tekortkoming van het ERP.
Wat er misgaat als je hier stopt: je hebt vier systemen die elk hun eigen deel van het antwoord kennen en geen enkel systeem dat het geheel ziet. De vragen die dat geheel nodig hebben, worden dan één keer per jaar in een spreadsheet beantwoord en de rest van het jaar niet gesteld.
Station 2. Ingestie, de bronze laag
Hier komen de gegevens binnen, ongewijzigd, precies zoals ze in de bron staan. Dat gebeurt via connectors: software die automatisch ophaalt op een vast ritme.
Dat het ongewijzigd binnenkomt lijkt overbodig en is het niet. Dit is de enige plek waar je later kunt aantonen waar een getal vandaan komt. Vraagt iemand over een half jaar waarom het cijfer in maart anders was, dan kun je het laten zien in plaats van het te beredeneren.
Wat een goede connector hier extra doet: hij controleert of wat binnenkomt eruitziet zoals verwacht. Het aantal records, de bandbreedte per veld, de verhouding tussen categorieën. Wijkt het af, dan gaat er een signaal uit voordat het rapport gedraaid wordt.
Wat er misgaat zonder: een leverancier hernoemt een veld, de koppeling blijft draaien, en die kolom komt voortaan leeg binnen. Drie maanden later constateert iemand dat de cijfers “een beetje raar” zijn, en dan begint het uitzoekwerk met de vraag sinds wanneer eigenlijk.
Station 3. Transformatie, de silver laag
Hier wordt opgeschoond. Dubbele records worden samengevoegd. Datumnotaties worden gelijkgetrokken. Een klant die in drie systemen anders heet, wordt één klant. Adresgegevens worden genormaliseerd. Ontbrekende waarden worden gemarkeerd in plaats van stilzwijgend op nul gezet.
Dit is het station waar het meeste werk zit en waar het meeste vakmanschap in gaat. Het is ook het station dat in offertes het minst zichtbaar is, omdat het resultaat ervan is dat er niets bijzonders gebeurt.
Een detail dat het concreet maakt. Bij Runderkamp bleek een PLU, de code waarmee een product wordt geïdentificeerd, in verschillende contexten net iets anders te betekenen. Datzelfde gold voor verpakkingseenheden en prijsafspraken. Het samenvoegen van circa 170 leveranciers tot ruim 1.400 gestandaardiseerde producten en PLU’s is silver-werk.
Wat er misgaat zonder: je koppelt systemen die het oneens blijven. Het probleem wordt zichtbaarder in plaats van kleiner, en het vertrouwen in de nieuwe oplossing daalt bij de eerste vergadering waarin twee cijfers naast elkaar staan.
Station 4. De semantische laag, de gold laag
Hier krijgen begrippen hun betekenis. Omzet, marge, doorlooptijd, actieve klant. Één keer vastgelegd, met een eigenaar erbij, op een plek waar systemen het kunnen lezen.
Deze drie lagen samen, bronze, silver en gold, heten de medallion-architectuur. De naam doet er minder toe dan de reden: ruwe gegevens, opgeschoonde gegevens en beslisklare gegevens zijn drie verschillende dingen en het loont om ze uit elkaar te houden.
In de gold-laag zit ook de semantiek van de gegevens zelf, niet alleen van de begrippen. Wat betekent een statuskolom met de waarden 1, 2, 3 en 7. Welke waarden kunnen samen voorkomen. Welke regels gelden bij het optellen. Dat is de kennis die bij de meeste bedrijven in twee of drie personen zit en nergens is opgeschreven.
Wat dit oplevert: het dashboard van de directie, het portaal van de klant en een AI-assistent lezen allemaal uit deze laag en geven daardoor hetzelfde antwoord op dezelfde vraag. Verandert de definitie, dan verandert alles mee. Één aanpassing in plaats van twaalf.
Wat er misgaat zonder: elk rapport kiest zijn eigen antwoord op de vraag wat marge is. Dat valt niet op zolang niemand ze naast elkaar legt, en het valt hard op zodra iemand dat doet.
Station 5. Toegang
Hier wordt vastgelegd wie welke gegevens mag zien. De vakterm is row-level security: toegang op rijniveau. Elke gebruiker ziet alleen de rijen die bij hem horen, ongeacht via welke route hij ze opvraagt.
Het verschil met toegang op schermniveau wordt duidelijk zodra er meer dan één route is. Bij schermtoegang bepaalt het rapport wat iemand ziet; komt er een export, een portaal of een assistent bij, dan moet de regel daar opnieuw worden ingebouwd. Wordt dat ergens vergeten, dan staat er een deur open die niemand heeft opgemerkt.
Bij rijtoegang erft alles wat op de gegevens draait dezelfde regel. Dat maakt drie dingen mogelijk die anders handwerk blijven: één dataset voor al je opdrachtgevers waarbij elke partij alleen zijn eigen deel ziet, een nieuwe klant toevoegen zonder dat er een omgeving gebouwd hoeft te worden, en een assistent die per gebruiker een ander antwoord geeft omdat hij per gebruiker andere gegevens ziet.
CentreBlock is hier het duidelijkste voorbeeld van in onze eigen praktijk: meerdere klanten in één analytics-omgeving, elk met zicht op alleen de eigen cijfers, met elf gestandaardiseerde KPI’s zodat de vergelijking tussen klanten en periodes betekenis heeft.
Wat er misgaat zonder: één vraag die net iets breder is geformuleerd, en er staat iets in het antwoord dat er niet had moeten staan. Dat is niet terug te nemen.
Station 6. Levering
Het laatste station is de vraag hoe de uitkomst bij een mens terechtkomt. Er zijn drie vormen en ze zijn niet uitwisselbaar.
Een dashboard, voor verkennende vragen. Waar zit onze marge, welke klantgroep groeit, wat is er veranderd. Daar wil je rondkijken en doorklikken.
Een signaal, voor bewakende vragen. Loopt er iets uit de bocht, en wie moet dat weten. Daar wil je een bericht op het moment dat het gebeurt.
Een portaal, voor externe partijen die hun eigen deel willen zien zonder dat jij het opstuurt.
De vuistregel die wij gebruiken: is de actie voorspelbaar, dan hoort het niet op een scherm. Kun je van tevoren opschrijven wat er moet gebeuren als een grens wordt overschreden en wie dat moet doen, dan bouw je een signaal en geen dashboard.
Wat er misgaat zonder: het inzicht bestaat wel en niemand handelt ernaar. Een dashboard vraagt om een gewoonte, en gewoontes verwateren. Na een kwartaal opent nog een enkeling het scherm.
En waar past AI dan?
Bovenop deze zes stations, en niet ertussen.
De techniek die je hier meestal tegenkomt heet RAG. Het model zoekt eerst het relevante stuk informatie op in jouw gegevens en formuleert daarna pas een antwoord, met dat stuk als basis. Dat is het verschil met een chatbot die uit zijn algemene training put.
Wat RAG nodig heeft, is precies de keten hierboven. Het moet zoeken in gegevens die uit meerdere bronnen bij elkaar zijn gebracht, station 2 en 3. Het moet weten wat een veld betekent om het juiste veld te pakken, station 4. En het moet per gebruiker andere gegevens zien, station 5.
Daarom is de volgorde in dit artikel niet omkeerbaar. Een AI-laag op station 1 is een chatbot die verzint. Een AI-laag op station 4 en 5 is een assistent die antwoord geeft op je eigen cijfers.
De kern in één zin.
Het verschil tussen een assistent die je kunt vertrouwen en een assistent die overtuigend fout zit, zit niet in het model. Het zit in de vier stations eronder.
Wat het kost om een station over te slaan
- 2. Ingestie. Wat je merkt: Cijfers wijken af zonder aanwijsbare oorzaak. Wanneer je het merkt: Maanden later, bij toeval.
- 3. Transformatie. Wat je merkt: Dezelfde klant of hetzelfde product telt dubbel. Wanneer je het merkt: Bij de eerste vergelijking tussen twee bronnen.
- 4. Semantiek. Wat je merkt: Twee rapporten geven twee antwoorden op dezelfde vraag. Wanneer je het merkt: In een vergadering, meestal ongelegen.
- 5. Toegang. Wat je merkt: Iemand ziet gegevens die niet voor hem bestemd zijn. Wanneer je het merkt: Achteraf, en dan is het te laat.
- 6. Levering. Wat je merkt: Het inzicht bestaat en niemand handelt ernaar. Wanneer je het merkt: Na een kwartaal, als het dashboard stil is.
Grenzen
Deze keten beschrijft wat er nodig is om van bron tot betrouwbaar antwoord te komen. Dat betekent niet dat elk bedrijf alle zes stations volledig moet inrichten.
Werk je met één systeem waar vrijwel alles in staat, dan zijn station 2 en 3 aanzienlijk lichter. Deel je niets buiten je eigen organisatie, dan is station 5 eenvoudiger. Neem je maandelijkse beslissingen, dan is station 6 minder kritisch dan bij een operatie die dagelijks bijstuurt.
Wat wij niet doen: een AI-laag bouwen op een fundament dat er niet is, ook niet als de klant erom vraagt en het budget er ligt. Niet uit principe, maar omdat het resultaat een assistent is die de eerste weken indruk maakt en daarna het vertrouwen in alle cijfers meesleept in zijn val.
Dit zijn oplossingspatronen, geen gegarandeerde uitkomsten. Wat het in jouw situatie oplevert hangt af van hoe scherp de vraag is waarmee je begint.
Woordenlijst
- Connector — Software die gegevens automatisch uit een bronsysteem haalt, inclusief controle en herkomst.
- Bronze, silver, gold — De drie lagen van de medallion-architectuur: ruw, opgeschoond, beslisklaar.
- Semantische laag — De plek waar is vastgelegd wat een veld en een begrip betekenen, leesbaar voor systemen.
- Row-level security — Toegang op rijniveau: elke gebruiker ziet alleen zijn eigen rijen, via welke route dan ook.
- RAG — Een AI-aanpak waarbij het model eerst de relevante informatie opzoekt in jouw gegevens en pas daarna een antwoord formuleert.
- Sharing Engine — De laag waarin dashboards, portalen en signalen vanuit dezelfde gegevens worden geleverd.
Tot slot
Zes stations klinkt als veel. In de praktijk bouw je ze niet allemaal in volle breedte, maar smal: één stroom van bron tot uitkomst, voor één vraag die er echt toe doet, met alle zes stations erin.
Dat is binnen weken te doen. En de tweede vraag is daarna aanzienlijk goedkoper, omdat de helft van het werk er dan ligt.