Wat dit artikel oplevert
- Je begrijpt waarom een AI-antwoord gevaarlijker is dan een verkeerd dashboard.
- Je kunt benoemen welke vier problemen onder vrijwel elke mislukte pilot liggen.
- Je kent de volgorde die wel werkt, en waarom die volgorde niet omkeerbaar is.
- Je weet wanneer een dataplatform bij jouw bedrijf níét de juiste keuze is.
Wat we bedoelen met een datafundament
Een datafundament is het geheel van koppelingen, definities, betekenis, toegangsregels en beheer waarmee informatie uit losse systemen bruikbaar wordt voor beslissingen. Het is geen product en geen server. Het is een vermogen dat je opbouwt en onderhoudt, net als een boekhouding.
Die vergelijking met een boekhouding is bruikbaarder dan hij lijkt. Ook een boekhouding is niet spannend, ook daar zit het werk in afspraken en discipline, en ook daar merk je pas dat hij ontbreekt op het moment dat je een vraag stelt waarop je een hard antwoord nodig hebt.
Het probleem is niet dat er data ontbreekt
Bijna elk bedrijf dat we spreken heeft de informatie al. Ze zit alleen verspreid over systemen die nooit zijn ontworpen om samen te werken, en die stuk voor stuk om goede redenen zijn aangeschaft.
Een ERP dat de klanten en de facturen kent. Een servicedesk die de meldingen kent. Een planningspakket dat de uren kent. Meetsoftware of een branchespecifiek pakket dat het werk zelf vastlegt. En daaromheen een verzameling spreadsheets waarin mensen de gaten hebben gedicht die tussen die systemen vielen.
Dat is geen slordigheid. Het is het normale resultaat van vijftien jaar verstandige losse aankopen. Spreadsheets waren jarenlang de beste beschikbare oplossing voor precies dat probleem, en dat zijn ze op sommige plekken nog steeds.
Wat er onder een mislukte AI-pilot ligt, valt bijna altijd in vier categorieën.
Eén. De bronnen zijn niet echt gekoppeld
“Wij hebben alles al gekoppeld” betekent in de praktijk vaak: iemand exporteert het elke maandag. Een export is een momentopname zonder herkomst. Verandert de bron van kolomnaam, dan draait de export gewoon door met een lege kolom en krijgt niemand een melding. En als die persoon met vakantie is, is er die week geen data.
Twee. Een begrip betekent op drie plekken iets anders
Vraag drie afdelingen hoeveel klanten je hebt en je krijgt drie getallen. Verkoop telt accounts, finance telt debiteuren met omzet dit jaar, service telt lopende contracten. Alle drie kloppen. Alle drie meten iets anders. Zolang mensen met elkaar praten, corrigeert het gesprek dat verschil. Software praat niet terug.
Drie. De betekenis van een veld zit in mensen
In vrijwel elke database staan kolommen met codes waarvan de betekenis nooit is opgeschreven. Een statuskolom met de waarden 1, 2, 3 en 7, waarbij die laatste waarde ooit is ingevoerd voor een specifiek geval en nu alleen nog bekend is bij een of twee mensen op de administratie. Zij zijn de semantische laag van dat bedrijf, en zij staan nergens gedocumenteerd.
Vier. Toegang is geregeld op schermniveau
Zolang mensen via rapporten bij gegevens komen, kun je toegang per rapport regelen. Dat werkt tot het moment dat er een tweede route bij komt: een export, een portaal, of een assistent die de onderliggende gegevens zelf leest.
Waarom AI die zwakte zichtbaarder maakt dan rapportage
Dit is het punt waar dit artikel om draait, en het wordt zelden gemaakt.
Een dashboard toont een getal in een context. Je ziet de grafiek ernaast, je ziet de vorige periode, je ziet dat de lijn een rare knik heeft. Als iets niet klopt, valt dat op en ga je bellen. Het formaat zelf nodigt uit tot twijfel.
Een taalmodel geeft je een zin. Vloeiend, compleet, zelfverzekerd. Er staat geen foutmarge bij, er staat geen bronvermelding bij, en er staat vooral niet bij dat de vraag op drie manieren uit te leggen was en dat het model er één heeft gekozen.
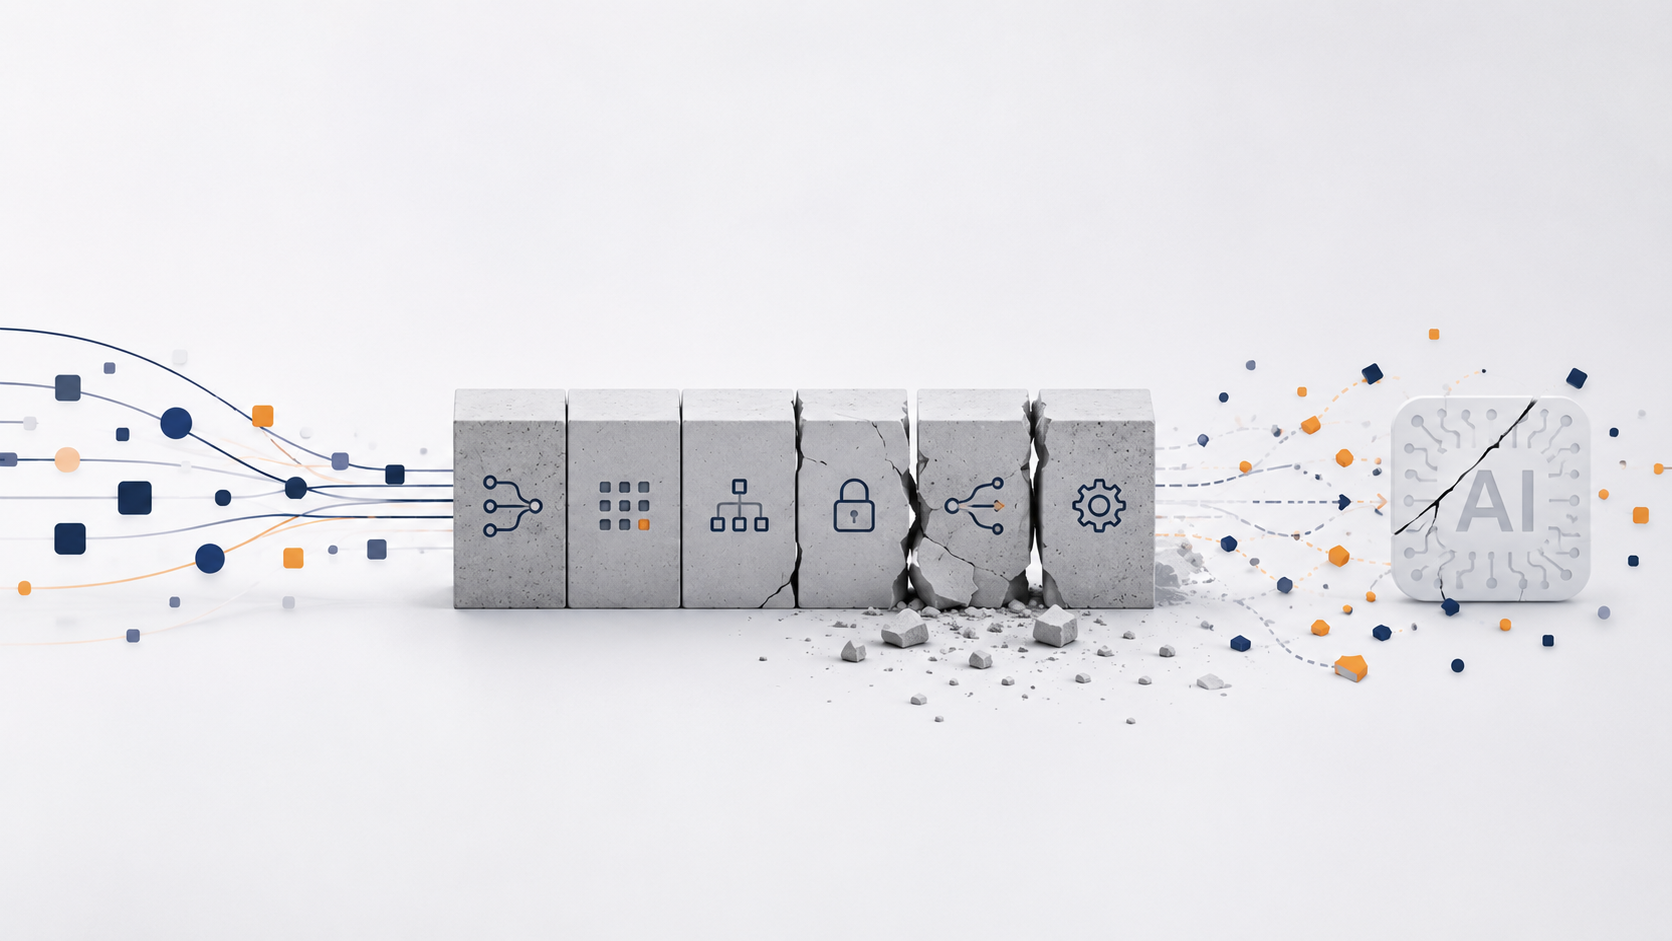
AI repareert een zwak informatiefundament niet.
Het vergroot de snelheid en de schaal waarop de gevolgen van die zwakte zich verspreiden.
Dat is niet omdat de techniek slecht is. Het is omdat een taalmodel is gebouwd om altijd te antwoorden. Vraag het naar je omzet bij je tien grootste klanten en het geeft een getal, ook als drie systemen drie omzetdefinities hanteren. Je krijgt geen melding dat de vraag meerduidig was. Je krijgt een antwoord.
Het risico is dus niet dat AI niet werkt. Het risico is dat het overtuigend werkt op een basis die dat niet verdient.
De volgorde die wel werkt
Er is een volgorde in dit werk en die is niet omkeerbaar. Elke stap leunt op de vorige.
- Centraliseren. De bronnen die samen het antwoord bevatten komen automatisch en herhaalbaar bij elkaar.
- Standaardiseren. Een begrip krijgt één betekenis, en die betekenis krijgt een eigenaar met een naam.
- Optimaliseren. De gegevens worden opgeschoond en gemodelleerd zodat ze bruikbaar zijn voor de vraag die je stelt.
- Automatiseren. Wat elke maand handmatig gebeurde, gebeurt vanzelf, inclusief de controles die melden als er iets afwijkt.
- Visualiseren. De uitkomst komt terecht op de plek en het moment waar de beslissing valt.
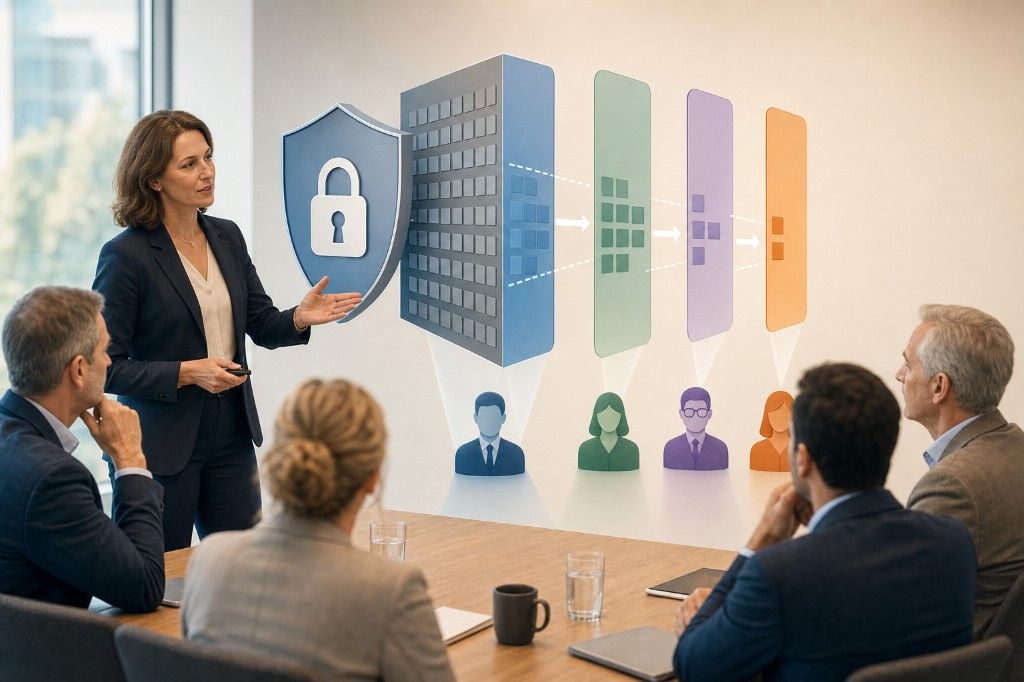
- Veilig delen. Externe partijen krijgen hun eigen zicht, met een grens die in de gegevens ligt en niet in het scherm.
Automatisering vergroot wat er al is. Automatiseer je een proces waarin een begrip drie betekenissen heeft, dan produceer je die drie betekenissen sneller en op grotere schaal. Dat is de reden dat stap twee niet overgeslagen kan worden, hoe verleidelijk dat ook is omdat het de minst technische en meest politieke stap is.
Hoe wij een traject inrichten
De praktische vertaling van die volgorde is korter dan mensen verwachten, en dat is met opzet.
- Business discovery. We bepalen welke uitkomst het waard is om aan te beginnen, en wie er last van heeft als hij uitblijft.
- Bron- en connectoranalyse. Welke systemen bevatten samen het antwoord op die ene vraag, en geen enkel systeem meer.
- Fundament inrichten. De koppelingen, de lagen en de omgevingen waarin gewerkt en getest wordt.
- Datamodellering en governance. De definities vastleggen op de plek waar rapportage ze ophaalt, met een eigenaar per begrip.
- BI bouwen. De eerste uitkomst opleveren die iemand daadwerkelijk gebruikt.
- AI bouwen. Pas hier, en alleen als het voorgaande staat.
- Live en doorlopend beheer. Controles die merken dat een bron verandert, en iemand die daar een melding van krijgt.
De verleiding is om stap drie en vier zo breed mogelijk te maken en pas daarna iets op te leveren. Wij hebben dat geprobeerd. Het resultaat was een architectuur waar de bouwers terecht trots op waren en waar de business een half jaar lang niets aan had. In dat half jaar verdween de urgentie en werd de vraag “waar was dit ook alweer voor” langzaam serieus gesteld.
Het MVP-principe.
Begin met één dunne, waardevolle stroom van bron tot uitkomst. Maak de architectuur eronder herbruikbaar, maar bouw niet het hele toekomstige platform voordat het eerste bedrijfsresultaat bewezen is.
Wat dit in de praktijk oplevert
CentreBlock levert impact-analytics aan meerdere klanten tegelijk. Elke klant wil zijn eigen cijfers zien, niemand mag die van een ander zien, en de vergelijking tussen periodes moet betekenisvol zijn.
Wat er is gebouwd: ruim een miljoen bezoekersrecords komen gestructureerd binnen, elf KPI’s zijn gestandaardiseerd zodat elke klant langs dezelfde meetlat gaat, en zeven vergelijkbare rapportageperioden zijn ingericht zodat een verandering ook echt een verandering is en geen verschil in meetmethode. Daarbovenop draait de gepatenteerde Impact Score.
De uitkomst waar het om ging: de doorlooptijd van rapportage ging van dagen naar minuten.
Wat daar hoort bij te staan: dit werkte omdat de vraag scherp was. CentreBlock wist precies welke uitkomst het nodig had, en dat maakte de keuze welke bronnen wel en niet meededen eenvoudig. Dit zijn oplossingspatronen, geen gegarandeerde uitkomsten.
Wanneer dit wél past en wanneer niet
Sterke match wanneer
- Meerdere systemen bevatten samen het antwoord op een terugkerende vraag.
- Er is een concrete vraag die nu te vaak met de hand beantwoord wordt.
- Er kan iemand worden aangewezen als eigenaar van de definities.
- Je rapporteert aan externe partijen die eigen inzicht willen.
- Groei betekent nu meer handwerk.
- Je overweegt AI en wilt weten wat daar redelijkerwijs voor nodig is.
Overweeg iets eenvoudigers wanneer
- Vrijwel alles staat in één systeem.
- Er is geen vraag die je nu niet kunt beantwoorden.
- Niemand krijgt tijd vrijgemaakt om definities te bewaken.
- Je deelt niets buiten je eigen organisatie.
- Het handwerk is beperkt en groeit niet mee.
- Je verwacht dat AI werk overneemt zonder dat er aan de gegevens iets verandert.
Woordenlijst
Datafundament: Het geheel van koppelingen, definities, betekenis, toegang en beheer waarmee informatie bruikbaar wordt voor beslissingen.
Connector: Software die gegevens uit een bronsysteem automatisch ophaalt, inclusief controle en herkomst.
Semantische laag: De plek waar is vastgelegd wat een veld betekent en hoe het zich verhoudt tot andere velden.
Row-level security: Toegang op rijniveau: elke gebruiker ziet alleen de gegevens die bij hem horen, ongeacht via welke route hij ze opvraagt.
DTAP: Development, test, acceptatie en productie: vier gescheiden omgevingen waarin een wijziging wordt gebouwd, getest, goedgekeurd en pas daarna doorgezet.
Tot slot
De vraag waarmee bij ons elk traject begint gaat niet over techniek, en het antwoord komt zelden van de IT-kant.
De startvraag.
Welke terugkerende beslissing, handmatige handeling, rapportageproces of dienst aan je klanten zou het meest verbeteren als de onderliggende informatie verbonden, betrouwbaar en veilig beschikbaar was voor de juiste mensen?
Stel die vraag eens aan iemand in je bedrijf die er niet over gaat. Meestal weet die persoon het antwoord precies, en heeft er alleen nooit iemand naar gevraagd.