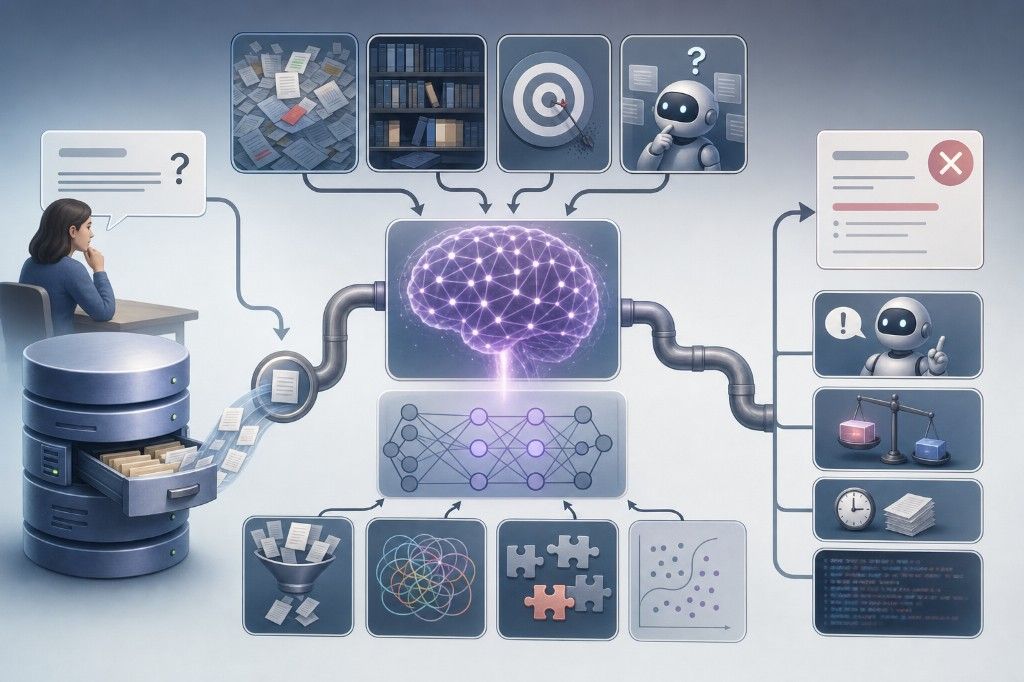
Je AI-tool heeft volledige toegang tot de database, maar geeft toch een fout antwoord of verzint iets dat er logisch uitziet maar niet klopt. Het probleem zit zelden in de toegang zelf. Het zit in semantische context: de betekenislaag die AI vertelt wat een tabel, kolom of KPI daadwerkelijk voorstelt. Zonder die laag ziet een taalmodel alleen ruwe velden, geen bedrijfslogica. Bij Impacture zien we dat terug bij elke klant die AI wil koppelen aan bestaande data: de techniek werkt, de betekenis ontbreekt.
Wat is semantische context en waarom is het cruciaal voor AI?
Semantische context is de laag die vastlegt wat data betekent, hoe begrippen zich tot elkaar verhouden en wie de eigenaar van een definitie is. Een kolom met de naam "omzet" zegt niets over of het bruto of netto is, of over welke periode. AI vult die leegte zelf in, en dat is precies waar een fout antwoord ontstaat.
In de praktijk zien we bij klanten dat twee afdelingen dezelfde term anders definiëren. Sales telt een order zodra hij binnenkomt, finance pas na facturatie. Een AI-laag zonder semantische context kiest willekeurig een van de twee, en niemand merkt het tot het rapport niet klopt.
Verschil tussen semantische context en semantische SEO of analyse
Semantische context gaat over betekenis in bedrijfsdata, niet over zoekmachineoptimalisatie. Semantische SEO helpt content beter aansluiten op zoekintentie via verwante begrippen. Semantische analyse in tekstverwerking haalt betekenis uit ongestructureerde taal.
Semantische context in een dataplatform is iets anders: het legt semantische relaties (de verbanden tussen begrippen, zoals "klant" en "order") vast in een model dat AI en mensen allebei kunnen raadplegen. Waar SEO en tekstanalyse draaien om taal interpreteren, draait semantische context om bedrijfsdefinities eenduidig maken. Verwar de twee niet als je een AI-project scoped, want de aanpak en de tools verschillen volledig.
Hoe embeddings en Knowledge Graphs semantische context creëren
Embeddings (wiskundige representaties van betekenis) en een Knowledge Graph (een netwerk van entiteiten en hun relaties) zijn de technische bouwstenen achter semantische context. Embeddings leggen vast dat "klant", "afnemer" en "opdrachtgever" naar hetzelfde begrip verwijzen. Een Knowledge Graph legt vast hoe die begrippen zich tot elkaar verhouden, bijvoorbeeld dat een klant meerdere locaties heeft en elke locatie eigen contracten.
Zet deze structuur op vóór je AI op je data loslaat. Koppel elke tabel aan een entiteit in de graph en geef elke KPI één eigenaar. Zo voorkom je dat een chatbot twee versies van "omzet" naast elkaar gebruikt zonder dat iemand het doorheeft.
Semantische context als remedie tegen AI hallucinatie
AI-hallucinatie (een antwoord dat overtuigend klinkt maar feitelijk onjuist is) ontstaat vaak omdat een model een betekenisgat zelf invult. Semantische context sluit dat gat: het model krijgt een vaste definitie in plaats van ruimte om te gokken.
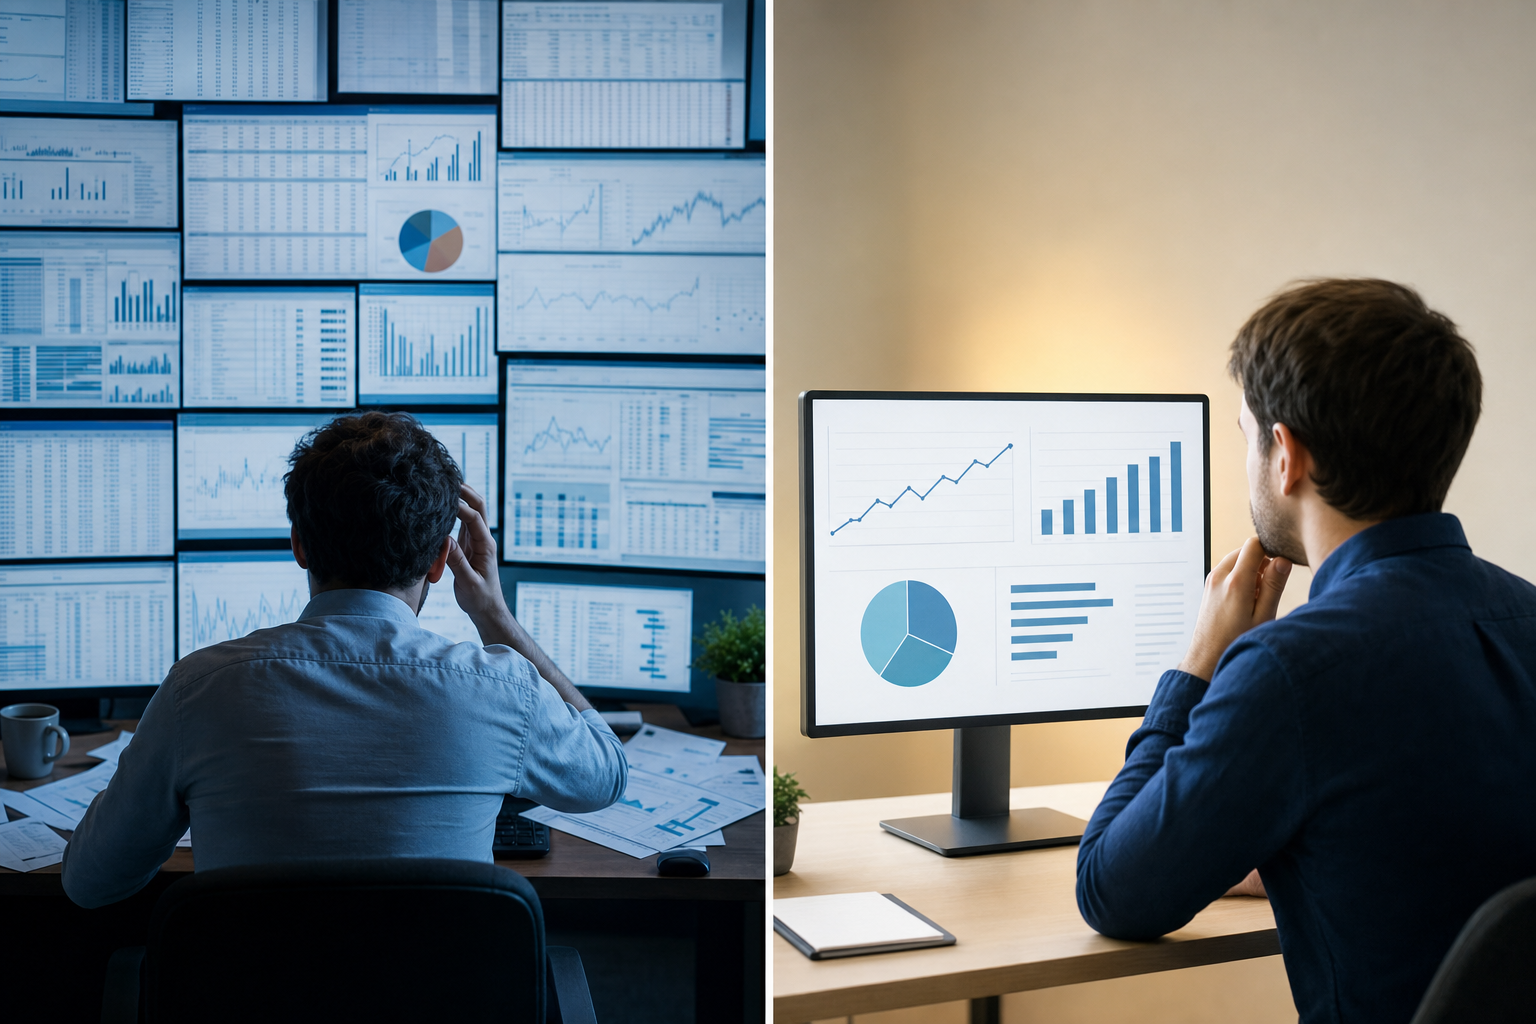
Dit weegt zwaarder bij een AI-laag dan bij een dashboard. In een grafiek zie je een knik en ga je zelf op onderzoek uit. In een gegenereerde zin zie je niets, het antwoord klinkt gewoon plausibel. Wil je AI database toegang geven zonder risico op stille fouten, zorg dan dat elk begrip waarop het model bevraagd wordt, één vastgelegde betekenis heeft voordat je de koppeling live zet.
Semantische context in Bronze, Silver en Gold lagen
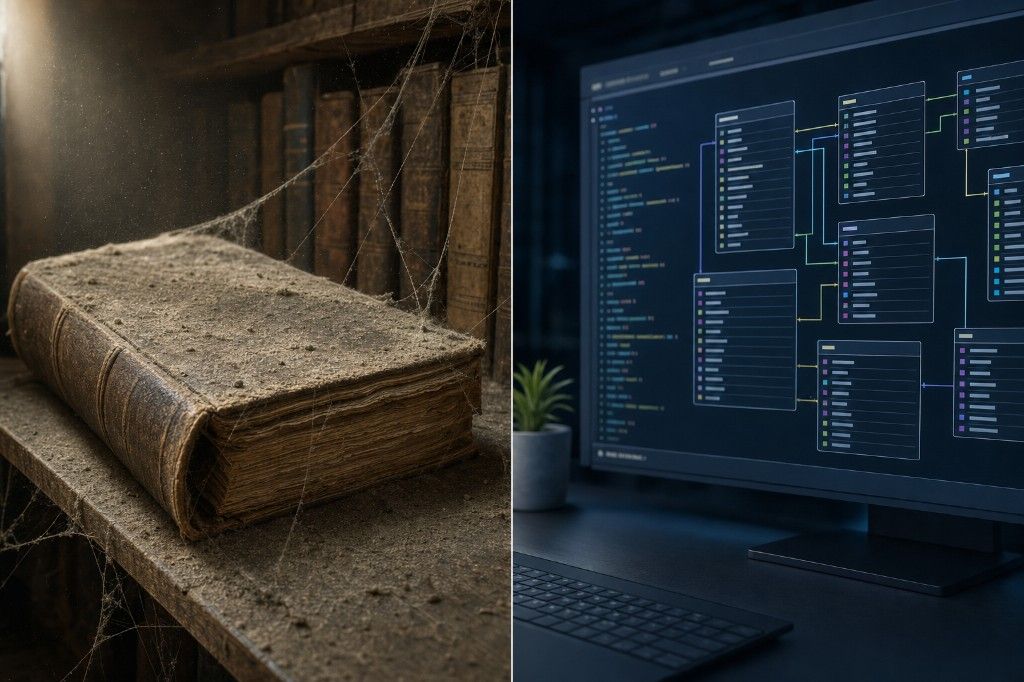
Een medallion architectuur (een gelaagde opbouw van ruwe naar verrijkte data, verdeeld in Bronze, Silver en Gold) is de plek waar semantische context praktisch wordt. Bronze bevat de ruwe, ongefilterde data uit bronsystemen. Silver is waar je definities standaardiseert en context toevoegt: hier bepaal je wat "omzet" of "klant" precies betekent voor de hele organisatie.
Gold levert de uitkomst, of dat nu een rapportage of een AI-agent is die zelfstandig een vraag beantwoordt. Rommelige data is werk, en de voorwaarden voor een schone Silver-laag zijn geen luxe. Richt de semantische laag in op Silver-niveau, zodat dashboards en AI-agents dezelfde definities raadplegen in plaats van elk hun eigen interpretatie te bouwen.
Praktische aanpak voor semantische context in je data platform
Zorg dat elk kernbegrip één eigenaar heeft die de definitie beheert en wijzigingen goedkeurt. Leg vast wie bij toegang tot welke data mag via row-level security (beveiliging die toegang beperkt tot de rijen die bij een gebruiker horen), zodat semantische context niet toevallig ook gevoelige informatie blootlegt aan de verkeerde gebruiker.
Test een AI-laag eerst op een smalle datastroom voordat je hem breed uitrolt. Bij CentreBlock ging rapportage hierdoor van dagen naar minuten, met elf KPI's die voor iedereen dezelfde betekenis hebben. Twijfel je of je semantische laag op orde is? Plan een Discovery Call en we zeggen het je eerlijk.
Een AI met volledige databasetoegang is pas betrouwbaar als de betekenislaag onder die data klopt. Semantische context bepaalt of een model feiten ophaalt of gokt, en dat verschil zie je terug in elk antwoord dat de organisatie op het model laat vertrouwen. Zonder die laag blijft AI database toegang een risico in plaats van een resultaat.