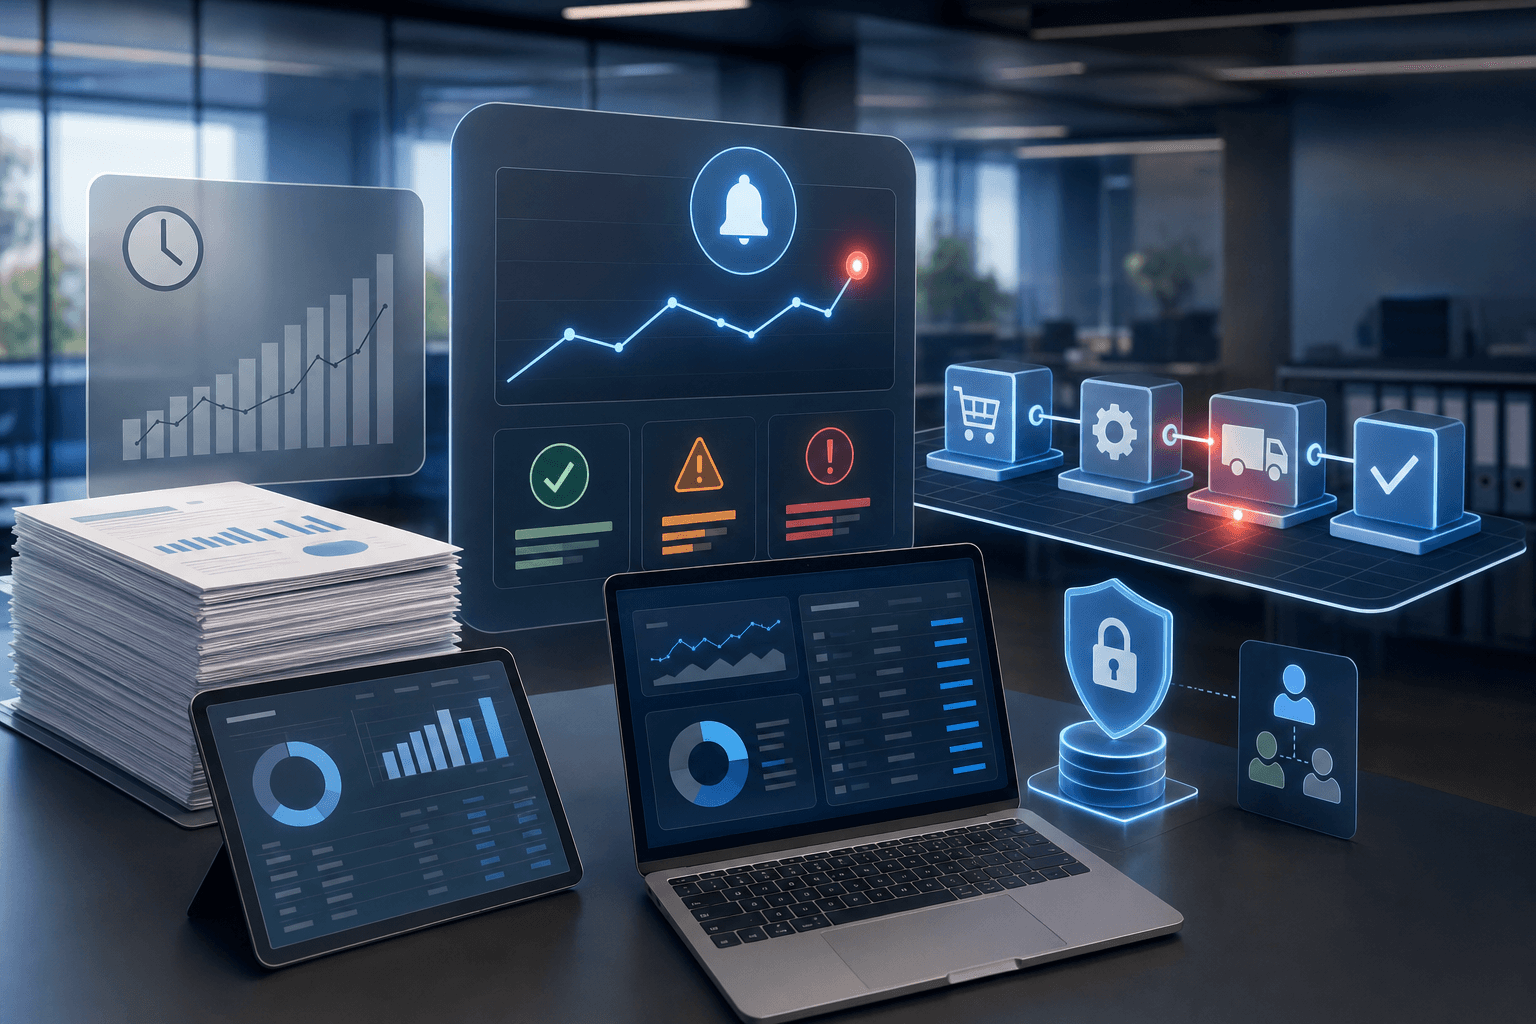
Een rapportage klopt deze maand niet meer, maar niemand krijgt een foutmelding. Geen crash, geen rode vlag in een dashboard. Toch wijkt een cijfer af van wat je verwacht. Dit heet data drift (een geleidelijke, stille verschuiving in databetekenis of -kwaliteit) en het is precies waarom databeheer meer is dan data opslaan. Goed databeheer signaleert deze verschuiving vóórdat een beslissing erop gebaseerd wordt.
Datastroom monitoring en data drift voorkomen
Datastroom monitoring betekent dat je continu controleert of binnenkomende data nog overeenkomt met wat je verwacht, in volume, structuur en betekenis. Zonder die controle verschuift een definitie langzaam zonder dat iemand het opmerkt.
Data drift ontstaat vaak klein: een leverancier wijzigt een productcode, een systeemupdate verandert een notatie, of een nieuwe medewerker vult een veld net iets anders in. Op zichzelf onschuldig, maar opgeteld schuift een hele rapportage weg van de werkelijkheid.
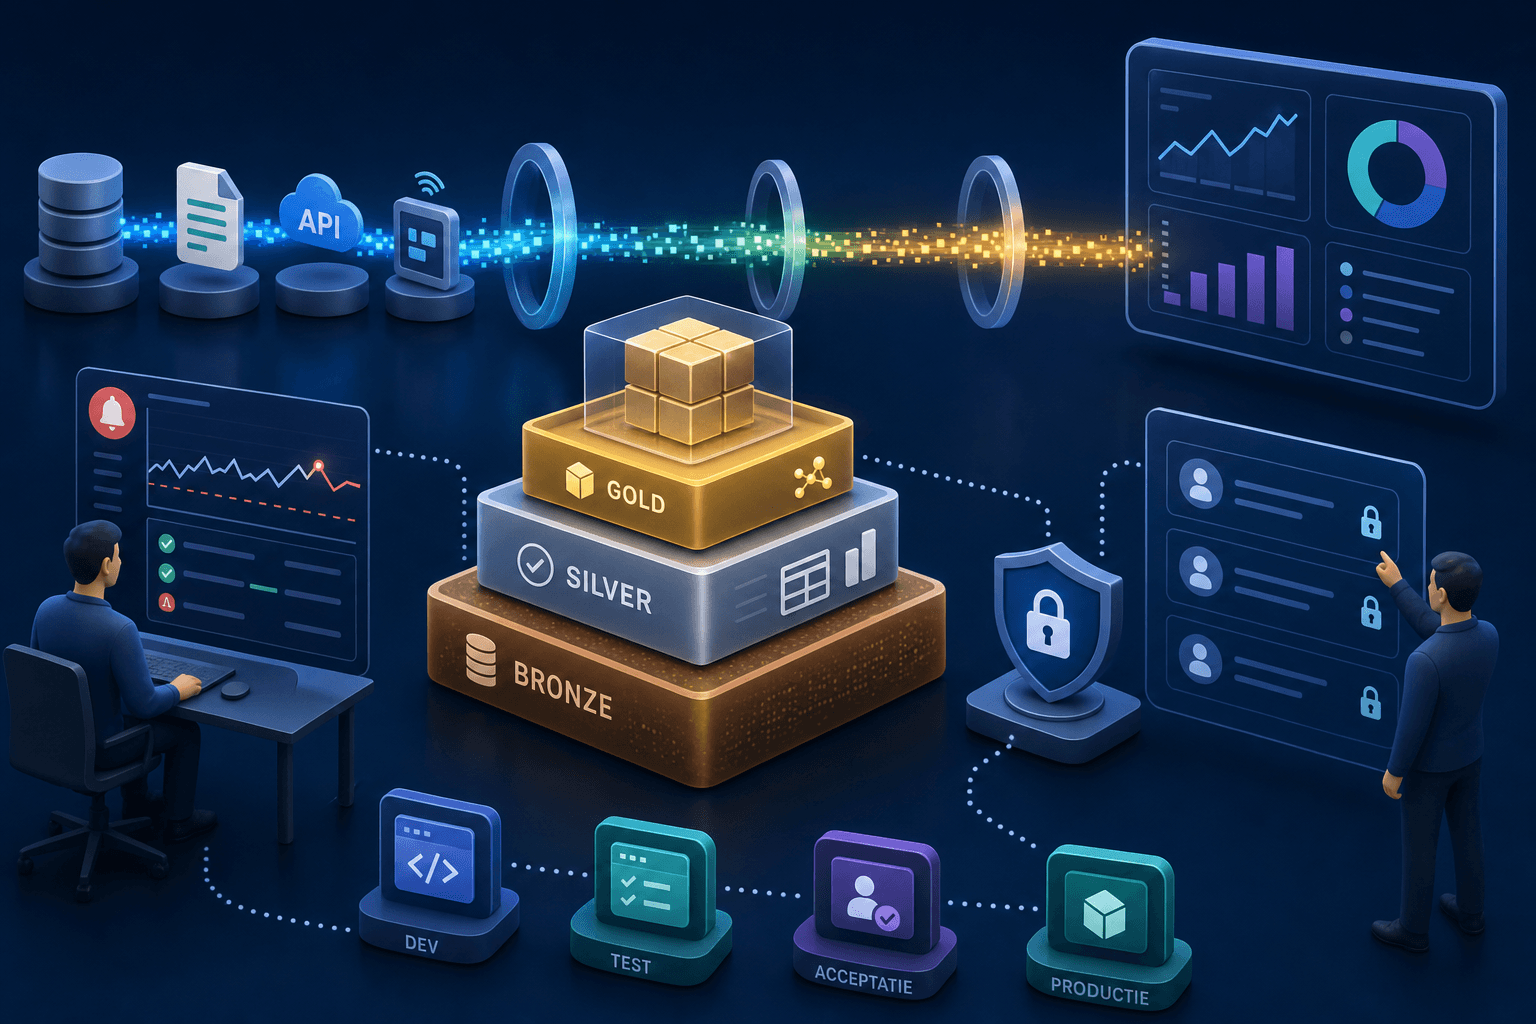
Zorg daarom dat elke datastroom een duidelijke eigenaar heeft die verantwoordelijk is voor controle op afwijkingen. Richt validatieregels in op de Bronze- en Silver-laag (de ruwe en opgeschoonde datalagen in een medallion-architectuur) zodat afwijkingen vroeg zichtbaar worden, niet pas in het eindrapport.
AI werkt op wat je hebt vastgelegd
AI en BI (business intelligence, het analyseren van data voor besluitvorming) zijn allebei afhankelijk van wat er structureel is vastgelegd, niet van wat er in theorie beschikbaar is. AI werkt niet op wat je hebt. AI werkt op wat je hebt vastgelegd.
Een chatbot of autonome workflow die beslissingen neemt op basis van verschoven of onvolledige data, neemt die beslissing met evenveel zelfvertrouwen als wanneer de data wel klopt. Rubbish in, rubbish out, alleen zie je het niet meteen terug in een grafiek.
Richt daarom dashboards en AI-agents in op dezelfde Silver Layer, de laag met opgeschoonde en gestandaardiseerde data. Zo kijken mens en algoritme naar dezelfde definities, in plaats van twee losse waarheden die langzaam uit elkaar groeien.
Governance en beveiliging vanaf dag één
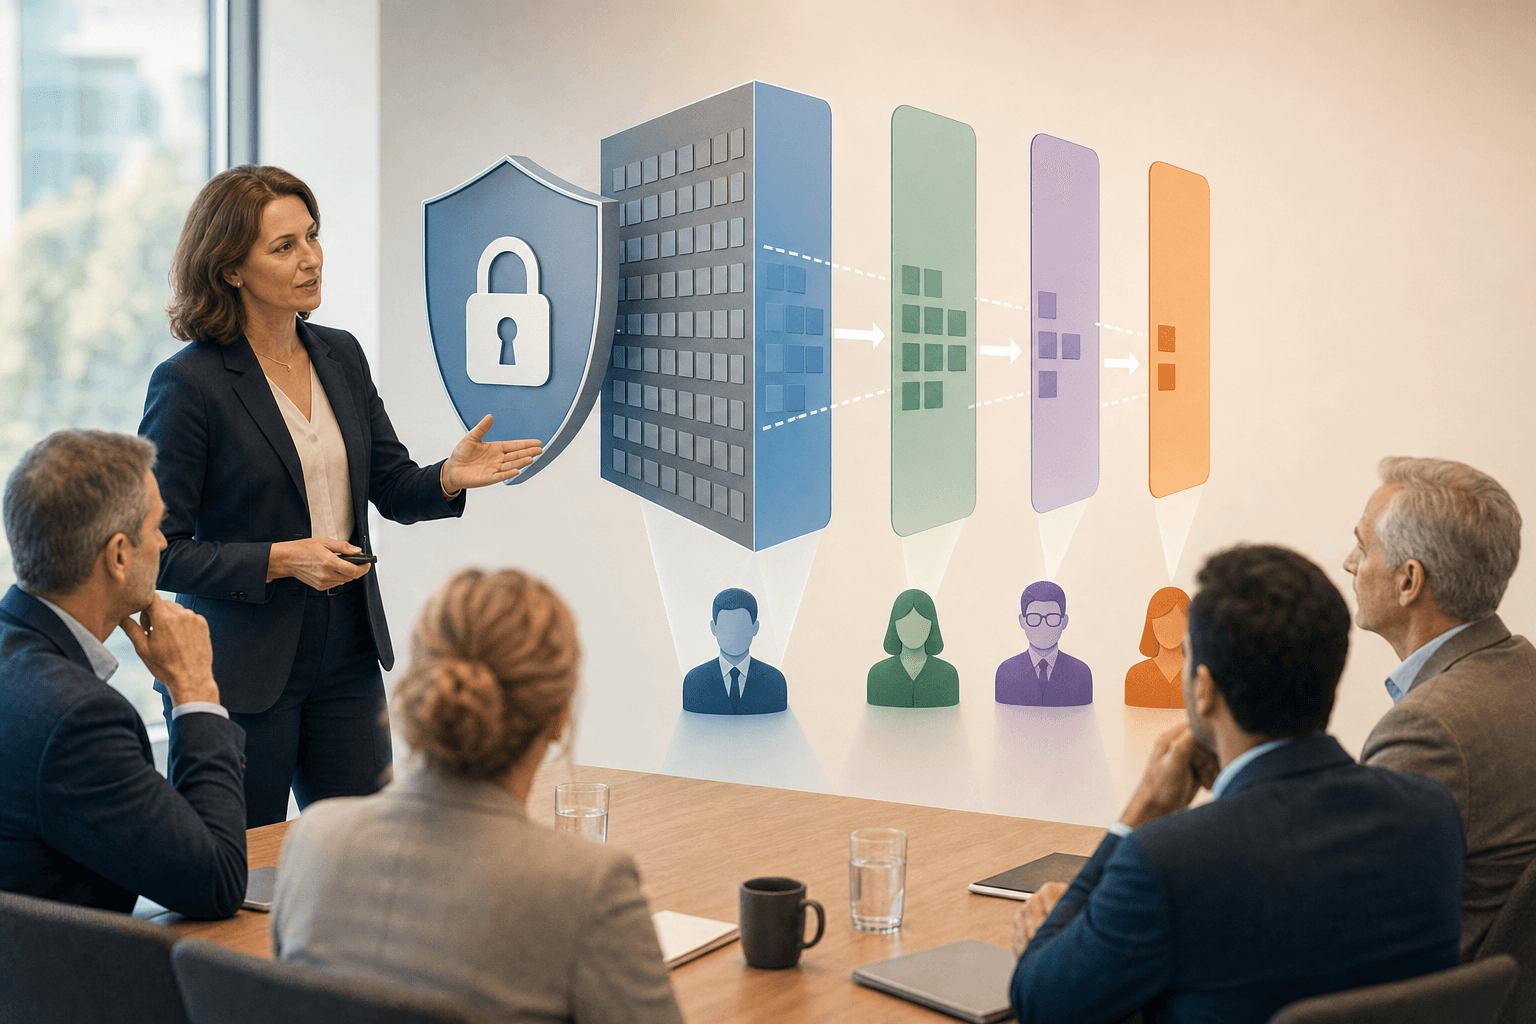
Governance (de afspraken en controles rond wie data mag inzien, wijzigen en delen) hoort bij de start van een datastroom, niet als toevoeging achteraf. Regel daarom row-level security (toegang tot data beperken op rijniveau, per gebruiker of klant) al tijdens de inrichting.
Gebruik DTAP-omgevingen (Development, Test, Acceptatie, Productie) zodat een wijziging eerst getest wordt voordat die in productie draait. Dat voorkomt dat een aanpassing in een rapportage onbedoeld een hele keten raakt.
Koppel toegang aan Azure AD of SSO zodat iedere medewerker, partner of klant alleen ziet wat voor zijn rol relevant is. Dit is niet overal wettelijk verplicht, maar wel vakinhoudelijk sterk aan te raden zodra je data met meerdere partijen deelt.
Eenduidige definities en semantische laag
Een cijfer is pas bruikbaar als iedereen dezelfde definitie hanteert. Zonder die afspraak noemt de ene afdeling een "actieve klant" iemand die deze maand besteld heeft, en de andere iemand die ooit klant was.
Een semantische laag (een context-laag die vastlegt wat een begrip precies betekent) lost dit op door één eigenaar per begrip aan te wijzen. Richt deze laag in op de Gold Layer, de laag waar data klaar is voor rapportage en AI.
Leg bij een AI-laag dit nog zwaarder vast dan bij een dashboard: in een grafiek zie je een knik bij een afwijkende definitie, in een gegenereerde zin van een AI-agent zie je dat niet.
Databeheer in de praktijk bij MKB
Bij een foodretailklant werden zo'n 1.400 producten en PLU-codes gestandaardiseerd en circa 170 leveranciers centraal gekoppeld, met vier DTAP-omgevingen in productie. Zonder die standaardisatie zou elke leverancierswijziging opnieuw tot stille afwijkingen leiden.
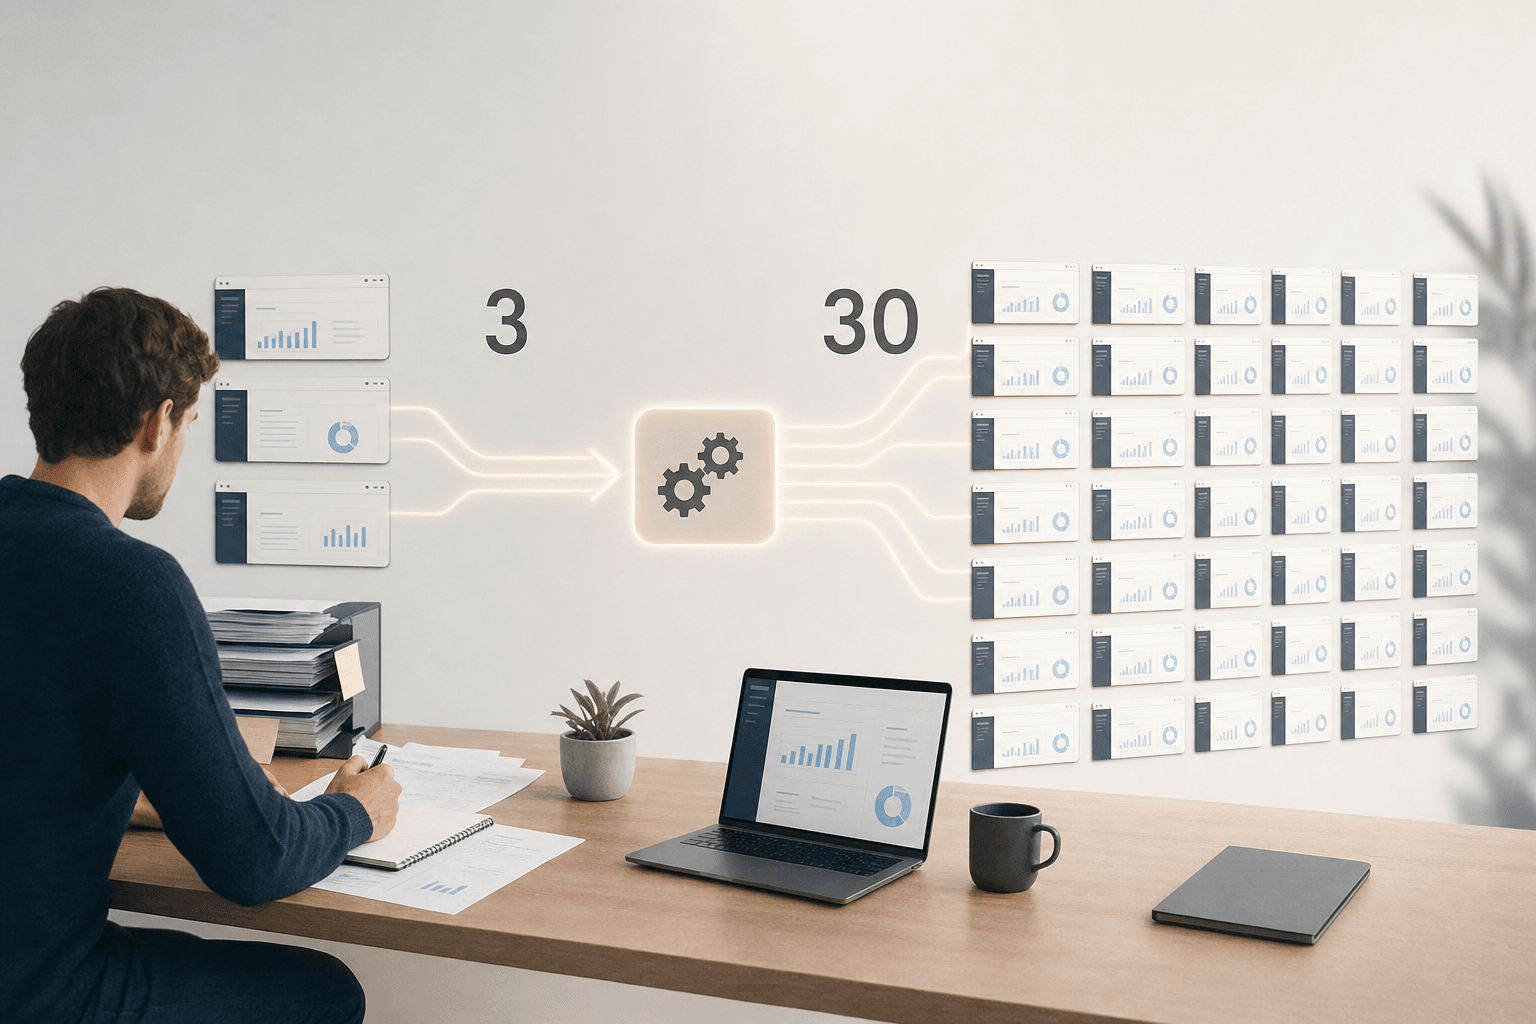
Bij een marketing intelligence-klant werden ruim 1 miljoen bezoekersrecords en 11 KPI's gestandaardiseerd binnen een multi-tenant omgeving met row-level security. Rapportages die eerder dagen kostten, verschijnen nu binnen minuten, omdat de onderliggende data al gecontroleerd en eenduidig is.
Doorlopend beheer en monitoring
Databeheer stopt niet bij oplevering. Richt monitoring in op dataflows zodat een stroom die begint te "schuiven" vroeg wordt opgemerkt, niet pas wanneer een rapportage al afwijkt.
Breid per nieuwe vraag of nieuwe databron de bestaande structuur uit in plaats van telkens opnieuw te beginnen. De architectuur onder één dunne stroom is dezelfde als onder een breed platform: klein starten is geen verspilling, maar de opzet die beheer op lange termijn haalbaar houdt.
Databeheer zonder foutmelding bij afwijkingen is geen klein euvel, het is een gat in je fundament. Met monitoring op datastromen, heldere definities en governance vanaf de start, blijft databeheer de basis waarop AI en BI betrouwbaar draaien. Twijfel je of jouw datastromen al "schuiven"? Plan een Discovery Call en we bekijken het samen.