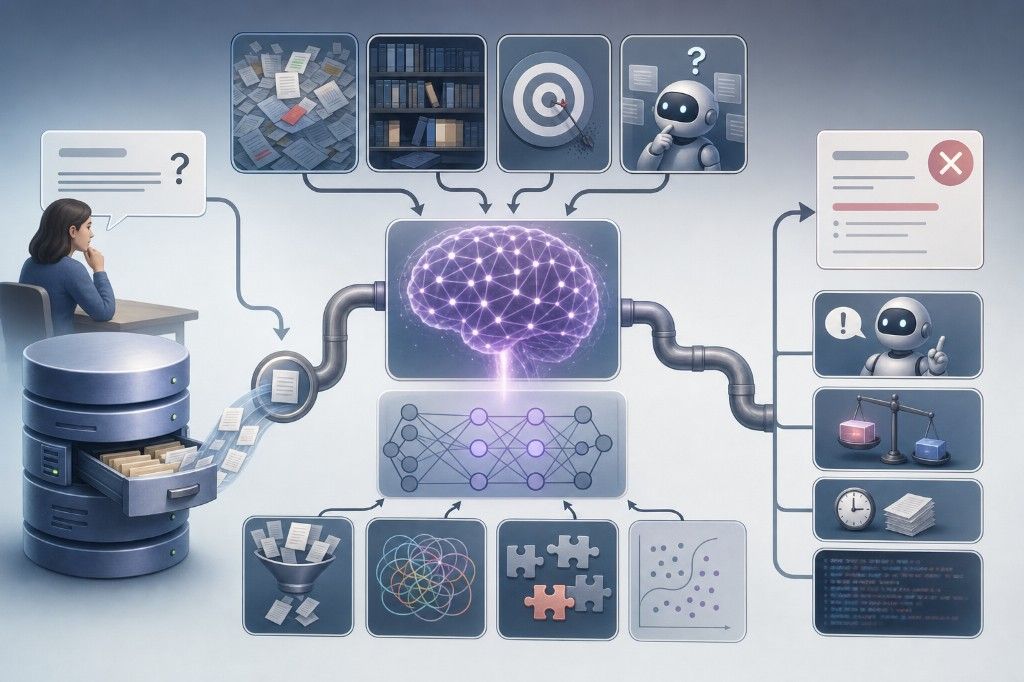
Een tabel vol klantnummers, PLU's en leveranciersdata vertelt je niets zolang niemand vastlegt wat die getallen betekenen. Dat is het verschil tussen semantiek versus opslag: opslag bewaart de data, semantiek legt vast wat die data betekent en hoe begrippen zich tot elkaar verhouden. Bij een dataproject aanpak die alleen naar opslag kijkt, loop je vroeg of laat vast op interpretatieverschillen tussen afdelingen.
De kernverschillen tussen semantiek en opslag
Opslaggerichte benadering draait om structuur: tabellen, kolommen, sleutels. Semantische modellering (het vastleggen van betekenis en relaties tussen begrippen) draait om interpretatie: wat is een "actieve klant", wat telt als "omzet"?
Een database kan feilloos werken en toch verkeerd gebruikt worden, simpelweg omdat twee afdelingen een ander beeld hebben bij hetzelfde veld. Regel dat op met één eigenaar per begrip, vastgelegd buiten het hoofd van één medewerker.
Context als sleutel tot betekenis
Hetzelfde getal betekent iets anders afhankelijk van de situatie waarin het wordt gebruikt. Die betekenisvariëteit ontstaat doordat dezelfde term in verschillende afdelingen een andere lading krijgt.
"Omzet" kan bruto of netto zijn, met of zonder retouren, per bestelling of per factuur. Contextuele verbijzondering (het per situatie vastleggen van de precieze betekenis van een begrip) voorkomt dat een dashboard en een AI-agent dezelfde term anders invullen. Leg per begrip vast in welke context het geldt, en wie daarover beslist.
Interoperabiliteit door semantiek
Systemen die dezelfde betekenislaag delen, kunnen zonder handmatig vertaalwerk met elkaar praten. Zonder die laag herbouw je bij elke koppeling opnieuw de vertaling tussen systeem A en systeem B.
Semantische interoperabiliteit werkt alleen als de betekenislaag los staat van het onderliggende systeem. Richt de semantische laag daarom in als apart onderdeel van je platform, niet als eigenschap van één specifieke tool of database.
Semantiek in de praktijk van dataprojecten
Een dataproject aanpak die met semantiek begint, voorkomt dat je halverwege een project moet terugkomen op afspraken. In de praktijk zien we bij klanten dat de meeste vertraging ontstaat door discussie over betekenis, niet door technische obstakels.
Begin daarom niet met de opslagstructuur, maar met de vraag welke begrippen er zijn en wie eigenaar is van elke definitie. Werk dat uit vóór je een Bronze-, Silver- of Gold-laag inricht (de opeenvolgende verwerkingsstappen van ruwe naar bruikbare data). Zo voorkom je dat een AI-laag straks rekent op aannames die niemand heeft vastgelegd.
Patronen en antipatronen
Een terugkerend antipatroon: dezelfde term met verschillende definities in verschillende systemen, zonder dat iemand dat merkt totdat een rapport en een dashboard elkaar tegenspreken. Bij een AI-laag weegt dit zwaarder dan bij een dashboard. In een grafiek zie je een knik, in een gegenereerde zin niet.
Een werkend patroon: één semantische laag boven de opslag, met een vaste eigenaar per begrip en een duidelijke koppeling naar de onderliggende Silver-laag. Richt die laag in vóórdat je automatisering of AI toevoegt, niet erna.
Volgende stap
Semantiek versus opslag is geen technische keuze maar een volgordekwestie: eerst betekenis vastleggen, dan pas automatiseren of visualiseren. Rommelige definities zijn werk, geen luxe om over te slaan. Twijfel je waar je moet beginnen met je dataproject aanpak? Plan een Discovery Call en we zeggen het je eerlijk.